“Centering”(中心化)在 LLM 的 RL 后训练里指的是减去某个量的均值,但不同语境下被减的东西不一样:
| 名称 | 减去的东西 | 目的 |
|---|---|---|
| baseline / 组均值(reward centering) | 奖励的均值 | 降低方差,梯度期望不变 |
| score centering | score function 的期望 | 在 off-policy 下消除 drift(漂移)偏差 |
| reward model centering | 每个 prompt 的奖励偏移 | 固定 BT 模型无法确定的常数 |
| KL 正则目标中的 centering | 配分函数 | 用均值奖励代替不可计算的 |
狭义的 score centering 来自 2026 年的两篇论文(Marek & Ryabinin, arXiv:2609.20807;Han & Hu, arXiv:2610.22263)。要看懂它,需要先把”为什么 on-policy 时 score 的均值为零”和”baseline 为什么不改变梯度”推一遍,所以本文按下面的顺序展开:
- 策略梯度和 score function 的零均值性质(§1)
- baseline 与协方差视角(§2)
- 最优 baseline(§3)
- 组均值:RLOO / GRPO / Dr. GRPO(§4)
- score centering(§5,本文重点)
- reward model 的 centering(§6)
- KL 正则目标中的 centering(§7)
- Sutton 的 Reward Centering(§8)
0. 记号
- :prompt;:模型生成的回答;:第 步的前缀。
- :正在训练的策略(trainer 端)。
- :整条回答的奖励(标量)。
- 目标函数:。
- score function:。注意这里的 “score” 是统计学术语(对数似然对参数的梯度),不是奖励分数。
- 词表 ,在固定前缀下第 个 token 的概率记为 ,其 score 记为 。
- :stop-gradient,前向取值不变,反向传播时梯度为零。
1. 策略梯度与 score function 的零均值性质
1.1 log-derivative trick
,对 求导时 不依赖 :
利用 ,即 ,代入:
这一步把”对分布求导”变成了”在分布下求期望”,于是可以用采样估计:采 ,用 作为梯度的无偏估计(REINFORCE)。
1.2 score 的期望为零
这是全文最关键的一个等式:
IMPORTANT
这个等式成立的前提是采样分布就是 本身(on-policy)。如果样本来自另一个分布 ,则 。§5 的 score centering 正是为了修补这一点。
1.3 token 级别的形式
自回归模型有 ,所以
1.2 的推导对每个前缀单独成立(把求和对象从”整条回答”换成”词表中的下一个 token”):
1.4 用 softmax 具体验证
设当前前缀下的 logits 为 ,。则
其中 是第 个 one-hot 向量(第二项来自 )。于是
直观上:采到 token 时,梯度把 的 logit 往上推(),把所有 token 按概率往下压()。按 平均后,推和压正好抵消。后文在 logit 空间里讨论时都用这个形式。
2. Baseline 与协方差视角
2.1 减 baseline 不改变梯度期望
对任意不依赖于 的 (可以依赖 ):
不依赖 这一条件不能省:它保证了 能从期望里提出来。如果 和 有关(例如 §4 中包含样本自身奖励的组均值),这一步就不成立。
2.2 协方差视角
协方差的定义是 。由于 on-policy 下 ,
协方差可以等价地写成三种形式:
这给出了理解所有 centering 的统一框架:策略梯度本质上是奖励与 score 的协方差,而估计协方差时可以对 中心化,也可以对 中心化。
- 对 中心化:baseline、组均值(§2.1、§4)。
- 对 中心化:score centering(§5)。
on-policy 时 ,对 中心化是”白做”,所以过去很少有人提。一旦采样分布偏离训练分布,,两种中心化就不再等价。
2.3 那为什么还要减 baseline?
期望不变,但方差会变。比如二元奖励 下,所有回答都错时 ;全对时 ,这一项期望为零但单个样本的值可能很大,纯粹是噪声。减去 baseline 后,只有”比平均好/差”的部分产生梯度。
3. 最优 baseline
单样本梯度估计量 是一个向量,它的”方差”取总方差 。由 §2.1, 与 无关,所以只需最小化
这是 的二次函数,令导数为零:
是以 为权重的奖励加权平均。如果 与 近似无关,,这就是实践中直接用”平均奖励”作 baseline 的理由。(Weaver & Tao 2001;Greensmith et al. 2004;Han & Hu 2026 Eq. 79 给出的也是这个形式。)
4. 组均值:RLOO、GRPO、Dr. GRPO
LLM 里通常拿不到 ,于是对同一个 prompt 独立采 条回答 ,奖励记 ,用组内统计量估计 baseline。
4.1 RLOO:留一法均值,严格无偏
RLOO(Ahmadian et al. 2024, arXiv:2402.14740)对第 条样本使用其他 条的均值作 baseline:
无偏性:()与 独立,所以 与 独立,可以先对 求条件期望:
因此 。
4.2 包含自身的组均值:差一个
GRPO 和 Dr. GRPO 用的是包含自身的组均值 。这时 含有 ,依赖于 ,§2.1 的论证不再直接适用。把 从 中拆出来:
所以组均值优势恰好是 RLOO 优势乘以常数 ,于是
这里的偏差只出现在尺度上,方向完全正确,可以并入学习率(Han & Hu 2026, Prop. 10 / Remark 2)。 时这个因子是 。
4.3 GRPO 的 std 归一化与长度归一化
GRPO(DeepSeekMath)的优势是
再把每条回答的 token 损失除以长度 。Liu et al.(Dr. GRPO, arXiv:2503.20783)指出这两个除法各引入一种偏差。
(1) std 带来的问题难度偏差。 同样依赖 ,而且不像 4.2 那样能拆成”常数 × 无偏项”,所以它带来的不只是尺度变化。更直观的影响是按 prompt 重新加权:二元奖励下若该 prompt 的正确率为 ,则组内 std ,
接近 0 或 1(太难或太简单)时 很小,权重很大。实际优化的目标因此变成了”按 加权的期望奖励”,而不是原始的 。
(2) 带来的长度偏差。 优势为正时,短回答的每个 token 得到更大的更新;优势为负时,长回答的每个 token 惩罚更小。结果是错误回答倾向于越写越长。veRL 里控制这一点的是 loss_agg_mode 参数(token-mean、seq-mean-token-mean 等,见 veRL 源码笔记),其中 seq-mean-token-mean 对应 GRPO 的按长度归一化。
Dr. GRPO 的修正(另见 RLVR 算法对比:Dr.GRPO):两个除法都去掉,
由 4.2,它的期望梯度是 。
REINFORCE++(Hu et al., arXiv:2501.03262)的折中做法是:先减组均值,再用整个 batch 的均值和标准差归一化。batch 很大时这些统计量近似为常数,不再随单个样本变化,从而避免了 (1) 中的问题。
5. Score Centering
5.1 问题来源:training-inference mismatch
实际的 RL 系统里,rollout 由推理引擎(vLLM / SGLang,可能还有量化、不同 kernel)生成,梯度由训练框架(FSDP / Megatron)计算。即便权重相同,两边算出的 token 概率也不完全一样;异步训练里 sampler 的权重还会落后若干步。这种现象称为 training-inference mismatch(TIM),它如何随训练放大并导致崩溃,可参考 这篇论文笔记。记
- :sampler(推理端)的分布,;
- :trainer(训练端)的分布,,梯度对它求。
样本 ,但 score 用 计算:。这时 §1.2 的前提被打破:
用 §1.4 的 logit 形式算一下,:
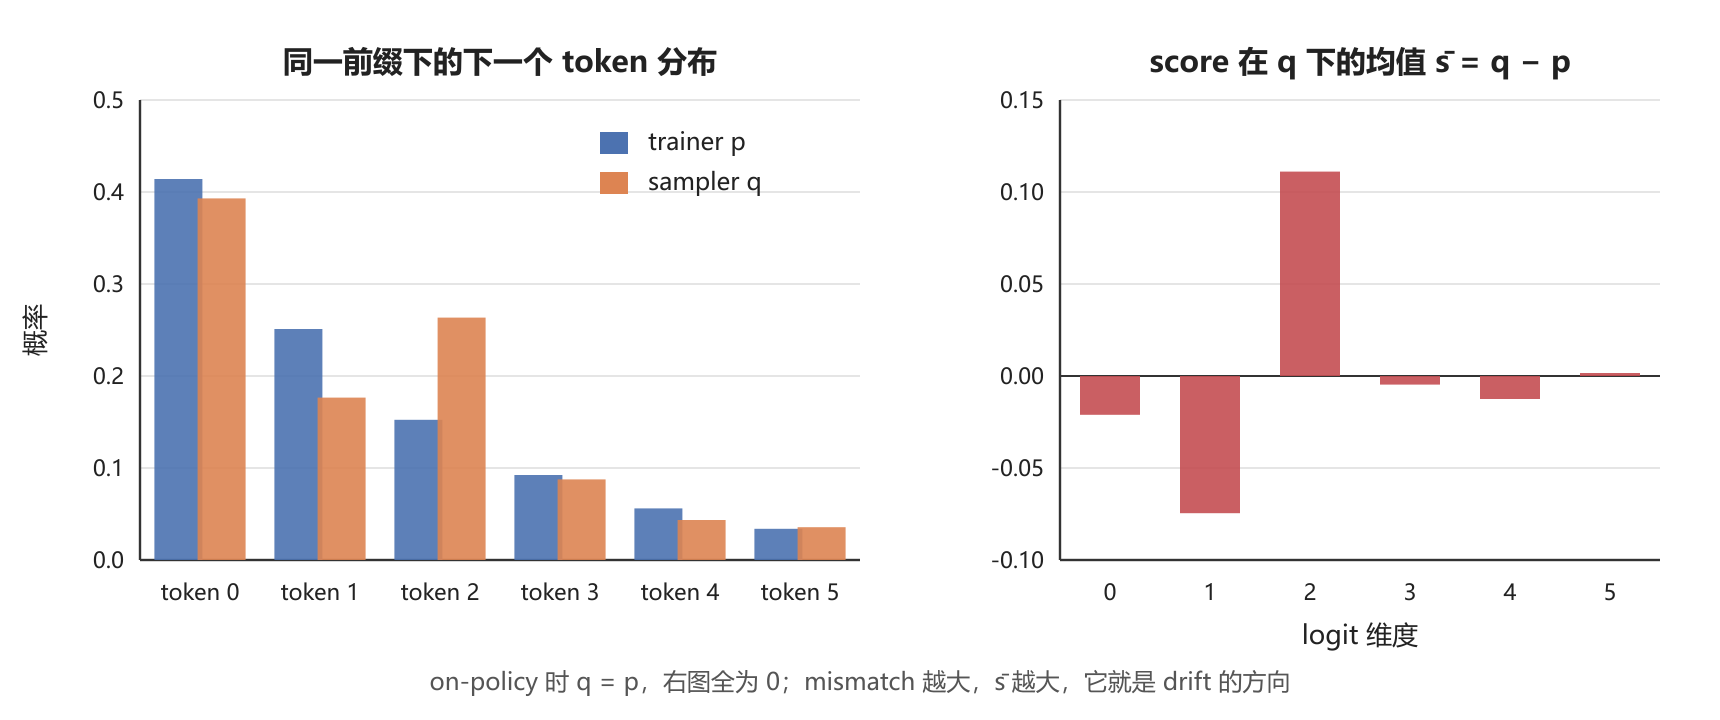
所以 就是两个分布之差 ,on-policy()时为零,mismatch 越大它越大。
下图是一个 6 个 token 的玩具例子:sampler 的 logit 带有一个固定的数值偏差,于是 与 略有不同(左),二者之差就是 (右)。
5.2 Drift / Signal 分解
不做重要性采样时,单个 token 的 REINFORCE 估计量期望为 。由协方差定义 :
- signal:奖励和 score 的协方差,即 §2.2 中真正有用的”策略梯度”部分。
- drift:在 logit 空间里等于 。它与奖励好坏没有关系,只要平均奖励为正,就把 往 拉(等价于把 trainer 往 sampler 蒸馏);平均奖励为负则往反方向推。
用上图的 、,设 token 0 是正确答案,奖励 (即 0/1 奖励整体加 1),把三项逐 token 算出来:
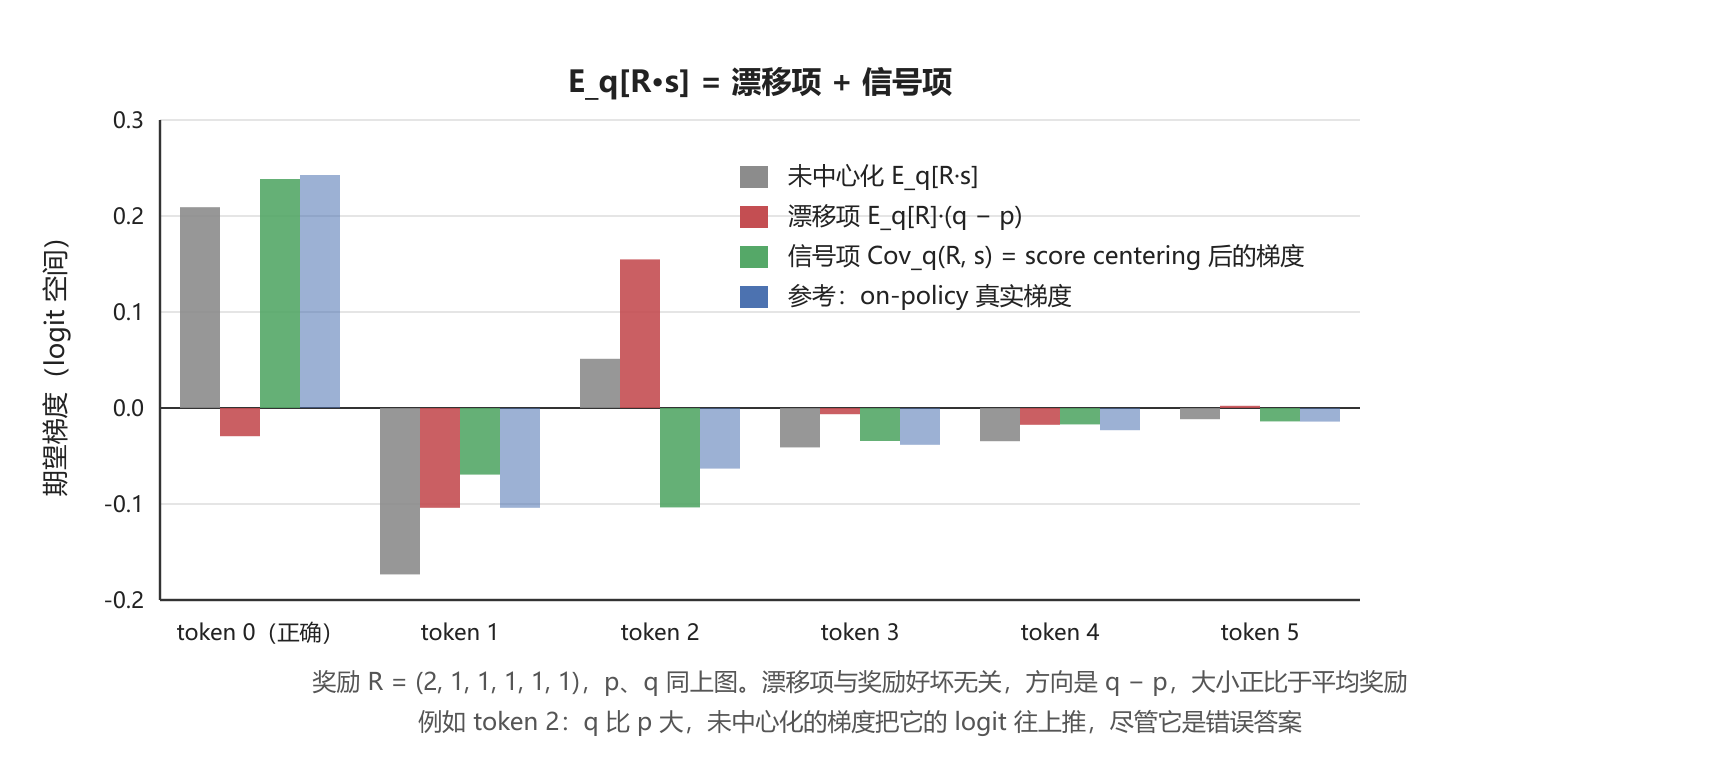
- 灰柱 = 红柱 + 绿柱,这就是上面的分解式。
- 绿柱(信号项)的符号与蓝柱(on-policy 真实梯度)一致:正确的 token 0 被往上推,其余被往下压。
- 红柱(漂移项)只取决于 。token 2 在 sampler 下被高估,漂移项把它往上推,以至于灰柱在 token 2 上是正的:未中心化的梯度在提高一个错误答案的概率。
把这几个 6 维向量画成箭头,看它们在梯度空间里的位置。横轴取 on-policy 真实梯度的方向,纵轴取 drift 中与它正交的部分。这个例子里四个向量恰好落在同一个平面内,所以投影没有丢失信息;两轴比例相同,图中的角度和长度都是真实的。
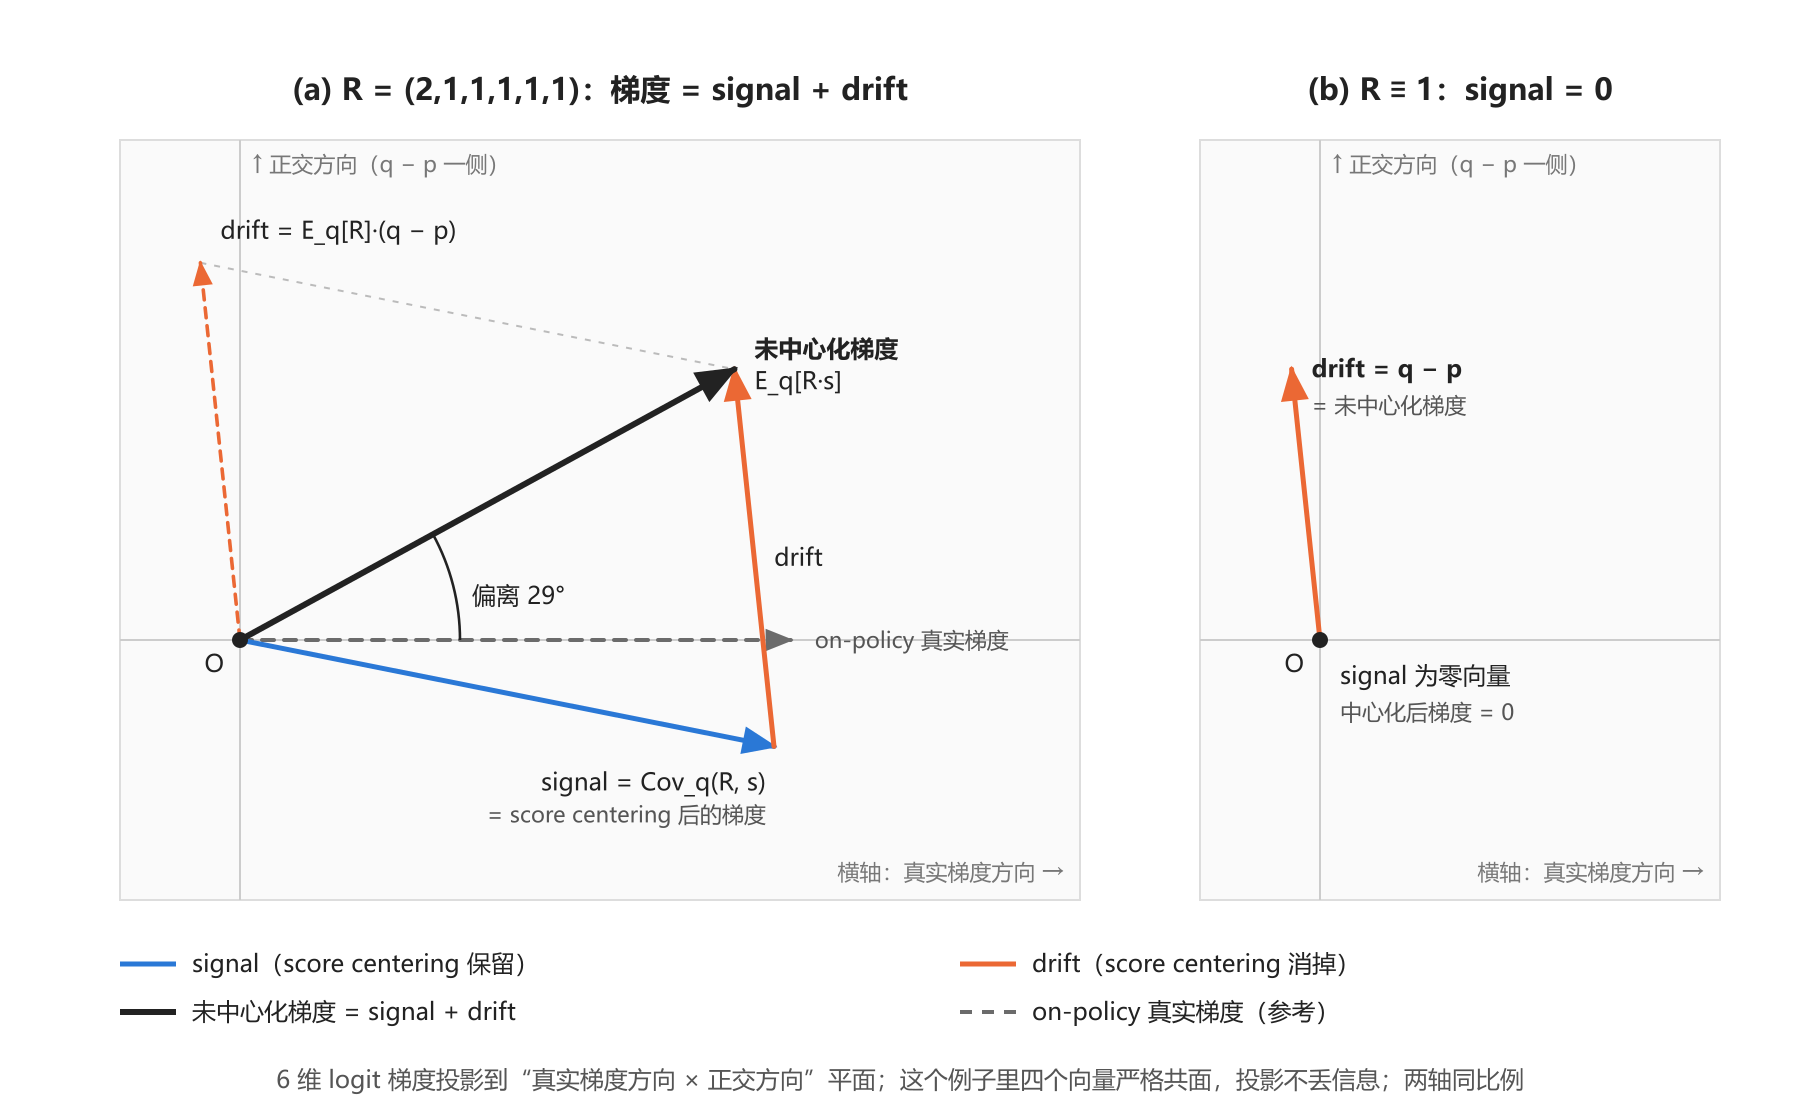
- (a):未中心化梯度(黑)是 signal(蓝)与 drift(橙)的向量和,即平行四边形的对角线。drift 几乎垂直于真实梯度,它不帮助学习,只把更新方向往 一侧拉偏了约 29°。score centering 去掉橙色箭头,更新方向就变回蓝色箭头。
- (b):奖励恒为 1 时 signal 是零向量,正确的更新应该是”不动”。未中心化梯度却等于 drift 本身,每一步都朝 推一下,这就是 §5.3 训练曲线 (a) 中 KL 持续上升的原因。((b) 沿用 (a) 的坐标轴。)
蓝色箭头和灰色虚线之间还有约 11° 的夹角:signal 是在 下算的协方差 ,而真实梯度是 。score centering 只去掉 drift,这部分剩余的 off-policy 偏差要靠重要性采样修正(§5.6)。
一个极端例子:假设所有回答奖励都是 。此时 ,没有任何学习信号,但梯度期望仍是 。每一步都推着参数朝”模仿推理引擎的数值误差”的方向走,而且这个偏差每步方向一致,会持续累积。论文认为这是 TIM 下训练不稳定的主要原因。
5.3 Score centering 的定义
把 score 减去它在 sampler 下的期望:
按构造,,在每个前缀上都成立。代回 5.2:
最后一步用到”减常数不改变协方差”( 在给定前缀下是常数)。所以 drift 被精确消掉,signal 原样保留。
在同一个玩具例子上跑 400 步 REINFORCE(logit 直接作为参数,学习率 0.5,batch 64,20 个种子平均):
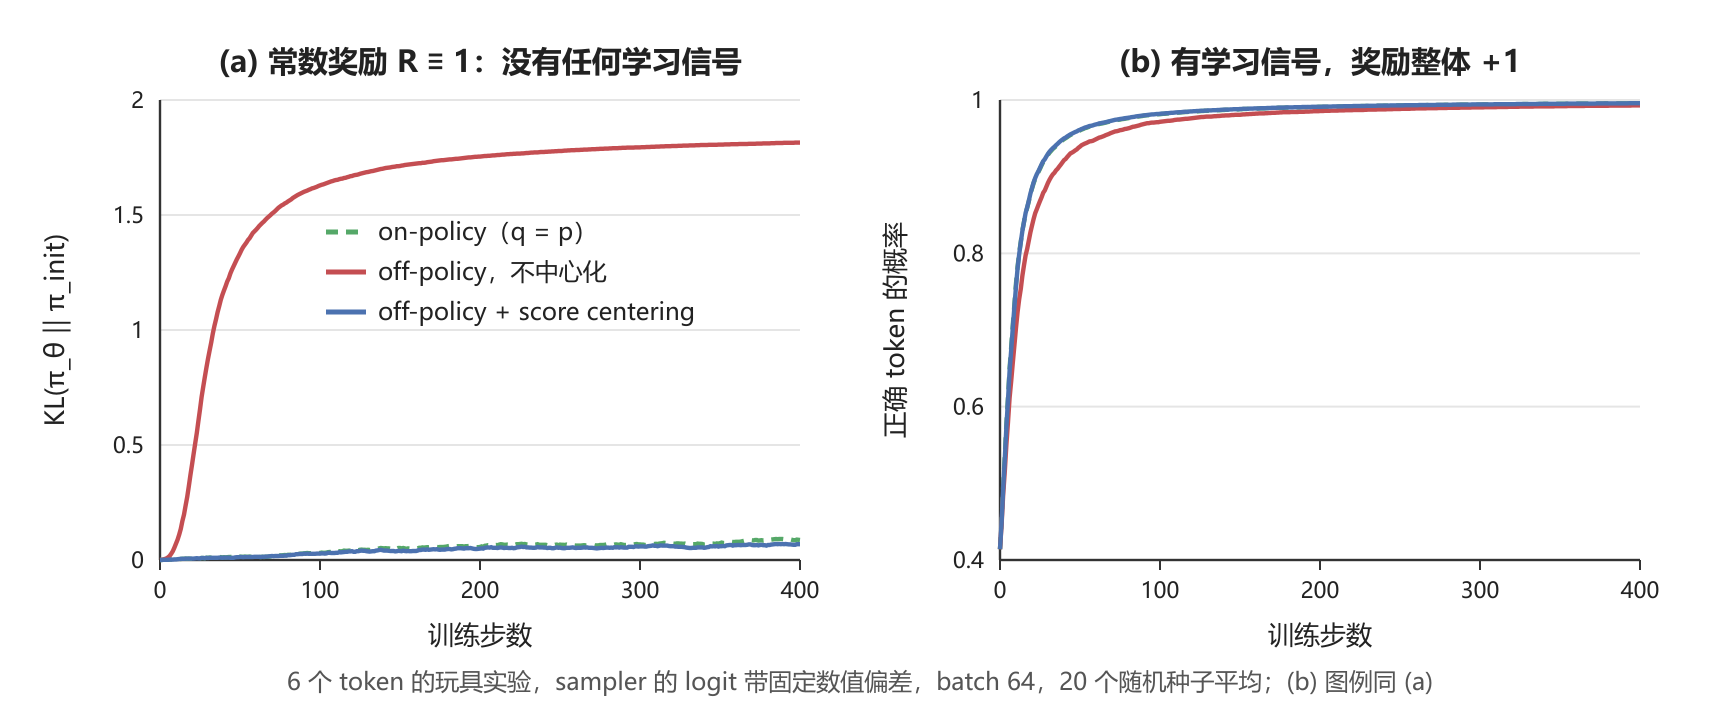
- (a) 常数奖励 :理论上梯度应为零。不中心化时(红)策略持续漂移,KL 升到约 1.8,相当于把 trainer 蒸馏成了 sampler;中心化后(蓝)KL 停在约 0.07,与 on-policy(绿)同一量级,剩下的只是采样噪声。
- (b) 有学习信号:三条曲线都能学会正确 token,但不中心化的那条始终慢一些,因为每一步都有一部分更新被漂移项”浪费”在拟合 上。中心化后的曲线与 on-policy 几乎重合。
这个例子里 mismatch 是固定的、奖励信号又很强,所以 (b) 的差距不大。真实训练中奖励信号弱、步数长、漂移方向持续一致,(a) 那种累积才是主要问题。
在 logit 空间里看更直观:
原来的 score 是”拿采样分布 的样本,配上 的中心”,两者对不上;中心化后变成 ,样本和中心都来自 ,均值自然为零。
这和 §2 的 baseline 是对偶的:baseline 对 做中心化,score centering 对 做中心化。§2.2 说过 on-policy 时二者等价,off-policy 时只有对 中心化才能去掉 带来的项。
5.4 写成 loss:stop-gradient 技巧
我们希望 autograd 算出 。注意 ,前提是 不参与求导。于是构造
验证:
括号里的第二项是 的相反数,也就是交叉熵 的相反数。所以 score centering 的 loss 等于普通 policy gradient loss 加上 :采到的 token 获得 倍的 log-likelihood 奖励,同时以同样的权重被要求”不要去拟合 的整体形状”。实践中 换成优势 (论文 Eq. 15 用的是 rollout 级优势 )。
5.5 Top-k 近似:不用存整个词表
需要 sampler 在整个词表(约 15 万)上的概率,每个 token 都存一份代价太高。论文只存 sampler 的 top-()概率,记这个集合为 ,其余为尾部 。近似方法可以这样推出:
- 把求和拆开:。
- 尾部的 不知道,用 trainer 概率按比例近似:(), 是两边尾部总质量之比,。
- 利用 trainer 自身的零均值性质 (§1.3),得到 。
- 合并:
对应的 loss(Eq. 8):
只需要 中 128 个 token 的 ,额外开销论文报告不到 1% 的 wall-clock。(上面 的具体表达式是我按”尾部质量之比”的描述写出的,具体请以原文为准。)
5.6 与重要性采样(IS)的关系
传统做法是用重要性权重 修正:
这样就回到了 on-policy,此时 ,drift 也随之消失。问题在于 方差可能极大,实际都会截断或裁剪(TIS、MIS、PPO clip),记为 。截断后
drift 又回来了。Han & Hu 正是从这一点出发:对正则化后的 IS,梯度不再对奖励的常数平移保持不变(把 换成 ,梯度多出 )。修复方法是对加权后的 score 做中心化:
Marek & Ryabinin 的 Eq. 14 给出了二者组合的 loss:
其中 对应 5.5 里尾部近似的系数。两种修正的性质不同:
| 重要性采样 | score centering | |
|---|---|---|
| 修正方式 | 乘法(对每个样本加权) | 加法(减去一个确定性的向量) |
| 是否引入额外方差 | 是, 可能很大 | 否, 是条件期望 |
| 超参数 | 截断阈值等 | 无 |
| 修正的偏差 | 全部 off-policy 偏差 | drift 部分 |
两者可以叠加使用,论文报告叠加的效果优于单独使用 IS,且 mismatch 越大,score centering 的收益越明显。
5.7 有了组均值 baseline,还需要 score centering 吗?
Han & Hu 的结论取决于 IS 作用在序列级还是 token 级。
序列级(Prop. 11):不需要。 设 , 为(加权的)序列 score,其总体均值为 。比较两个估计量:
由于组内对称,,所以第二项为零,两者期望相同。也就是说,组均值 baseline 已经保证 被中心化,再对 中心化在期望上没有作用。
token 级(Prop. 15):需要。 序列奖励 要乘以每个 token 的 score,token 的 drift 为
组均值 对整组只有一个值,只能抵消 prompt 层面的平均奖励;而 随前缀变化(写到一半已经走上正确思路的前缀,期望奖励更高)。只要它与 相关,这一项就不为零。论文把这个偏差写成 :精确 IS 下 ,偏差为零;截断 IS 下偏差非零。(这一段的条件期望推导是我为了说明直观而写的,严格形式见原文 Prop. 15。)
实践建议(Han & Hu),整理成决策流程:
flowchart TD
    A["采样策略 q 与训练策略 p 是否一致?"] -->|"是(严格 on-policy)"| B["组均值 baseline 即可<br/>E_p[s] = 0,score centering 无作用"]
    A -->|"否(TIM / 异步 / 陈旧策略)"| C["是否使用重要性采样?"]
    C -->|"否"| D["加 score centering<br/>消除漂移项 E_q[R]·(q − p)"]
    C -->|"是"| E["IS 作用在哪个层级?"]
    E -->|"序列级"| F["组均值 baseline 即可<br/>(Prop. 11)"]
    E -->|"token 级"| G["权重是否被截断 / 裁剪?"]
    G -->|"否(精确 IS)"| H["组均值 baseline 即可<br/>E_q[w·s] = 0"]
    G -->|"是(TIS / MIS / PPO clip)"| I["加 score centering<br/>+ 组均值或常数 baseline(Prop. 15)"]
- 序列级 IS(如 GSPO 一类):只用组均值 baseline 即可。
- token 级 IS 且权重被截断或裁剪(大多数 PPO / GRPO 实现):加上 score centering,可以搭配组均值,也可以搭配常数 baseline。
6. Reward Model 的 centering
6.1 Bradley-Terry 模型的平移不变性
奖励模型用偏好数据训练,BT 模型(Efficient Exploration at Scale 中也用它建模偏好)为
令 , 是任意只依赖 prompt 的函数:
似然完全不变,所以BT 损失只能确定奖励到一个 per-prompt 常数为止。训练出来的 的”零点”是任意的,可能随 prompt 漂移。
6.2 这对 RL 有什么影响?
由 §2.1,on-policy 下 相当于一个 baseline,不影响梯度的期望,只影响方差。但以下几种情况它会产生实际影响:
- 不减 baseline 时方差大: 很大时, 被一个与好坏无关的大常数放大。
- off-policy / 截断 IS 下:§5.6 说明此时梯度不再对平移保持不变, 直接变成 drift 的系数 。
- 与 KL 惩罚相加: 中两项的相对大小取决于 的零点。
- 集成多个 RM:不同成员学到不同的 ,取 median / min 就没有意义了。
6.3 实践中的做法
- InstructGPT(arXiv:2203.02155):用一个偏置把奖励模型归一化,使人工示范回答的平均分为 0,再开始 RL。原文:“since the RM loss is invariant to shifts in reward, we normalize the reward model using a bias so that the labeler demonstrations achieve a mean score of 0 before doing RL.”
- Llama 2(arXiv:2307.09288):对组合后的奖励做 whitening(中心化并缩放),,再减 KL 惩罚。
- Eisenstein et al.(Helping or Herding?, arXiv:2312.09244):在 RM 训练损失中加一个 centering 正则项,
BT 损失只约束差 ,这个正则项约束和 趋于 0,相当于把 固定为”使每对偏好的平均奖励为零”。差和和两个方向合起来就把 、 都确定下来了。
7. KL 正则目标中的 centering:用均值奖励代替
7.1 最优策略的闭式解
KL 正则的 RL 目标:
把 KL 展开并提取 :
定义 和 ,则 ,上式变为
与 无关,KL 非负且仅在 时为零,所以最优策略就是 。反解奖励:
7.2 也是一个 per-prompt 常数
只依赖 ,和 §6.1 的 是同一类东西。 要对所有回答求和,没法直接算,常见的处理有两种:
(a) 成对作差消掉(DPO、REBEL)。同一 prompt 的两条回答相减, 抵消:
DPO 把它代入 BT 模型(损失形式见 RLVR 算法对比:DPO);REBEL(arXiv:2404.16767)用平方损失回归这个差。
(b) 用组均值奖励近似(Kimi k1.5, arXiv:2501.12599)。以上一轮策略 作参考、温度为 ,最优性条件 给出平方损失
把 换成 个样本的平均奖励 。
为什么这个近似合理? 对 在 下取期望:
于是 。当 较大或每轮更新幅度较小时 KL 项很小,。(这一推导是我为解释 Kimi 的做法补充的,原文只说明了这个近似在实践中效果良好。)
再看损失对 的梯度:在 处 log-ratio 为 0,
正好是带组均值 baseline 的 REINFORCE(差一个常数)。所以”用 代替 “和 §4 的组均值 baseline 本质上是同一件事。
(c) 把 当作参数来学。FlowRL 用一个 3 层 MLP 预测 ,与策略一起放进 trajectory balance 平方损失训练。它和 (b) 处理的是同一个 per-prompt 常数,区别在于用网络去拟合,而不是用组均值去估计。
8. Sutton 的 Reward Centering(持续任务中的 TD 学习)
Naik, Wan, Tomar & Sutton, Reward Centering(arXiv:2405.09999)讨论的是另一种设定:没有终止状态的持续任务,用折扣 TD 学习价值函数。LLM 的单轮 RLVR 一般不属于这种设定,但它的分解能解释”为什么要把奖励的均值拿掉”。
8.1 Laurent 分解
设策略 下的平均奖励为 。折扣价值函数可以分解为
其中 是差分价值(differential value),()。
第一项的来源:如果每一步都恰好拿到平均奖励 ,折扣回报就是几何级数
这一项对所有状态都一样,不影响”哪个状态更好”,但 时会被放大 100 倍、 时放大 1000 倍。函数近似器要花大量容量去拟合这个与决策无关的大常数。
8.2 中心化后的 TD 更新
把每步奖励减去平均奖励的估计 ,Laurent 分解的第一项就消失了:
的两种估计方法:
- 简单中心化:,即奖励的滑动平均。on-policy 时没问题,off-policy 时估计的是行为策略的平均奖励,有偏差。
- 基于价值的中心化:用 TD 误差更新 ,
其中 为重要性采样比, 控制均值估计的相对步长。
这里简单中心化在 off-policy 下有偏的现象,和 §5 中”均值要在正确的分布下算”是同一个问题。
9. 总结
所有 centering 都基于同一个事实:
梯度只依赖奖励和 score 的协方差,常数部分只贡献噪声或偏差。
| 方法 | 中心化的对象 | 关键性质 |
|---|---|---|
| baseline | on-policy 下期望不变,降方差;最优 | |
| RLOO | 严格无偏 | |
| Dr. GRPO | RLOO,只差尺度 | |
| GRPO(std 归一化) | 按 重新加权 prompt | |
| score centering | off-policy 下消除 drift ;token 级截断 IS 时组均值无法替代它 | |
| RM centering | 固定 BT 模型的平移自由度 | |
| Kimi k1.5 | 代替 | 一阶梯度等价于组均值 baseline |
| Sutton reward centering | 去掉 ,off-policy 需用 TD 误差估计均值 |
参考资料
- Marek & Ryabinin, Score Centering Stabilizes Off-policy Reinforcement Learning, 2026. https://arxiv.org/abs/2609.20807
- Han & Hu, Baselines and Score Centering in Policy Gradient Estimation, 2026. https://arxiv.org/abs/2610.22263
- Naik, Wan, Tomar & Sutton, Reward Centering, 2024. https://arxiv.org/abs/2405.09999
- Ahmadian et al., Back to Basics: Revisiting REINFORCE Style Optimization for Learning from Human Feedback in LLMs (RLOO), 2024. https://arxiv.org/abs/2402.14740
- Liu et al., Understanding R1-Zero-Like Training: A Critical Perspective (Dr. GRPO), 2025. https://arxiv.org/abs/2503.20783
- Hu et al., REINFORCE++, 2025. https://arxiv.org/abs/2501.03262
- Ouyang et al., Training language models to follow instructions with human feedback (InstructGPT), 2022. https://arxiv.org/abs/2203.02155
- Touvron et al., Llama 2, 2023. https://arxiv.org/abs/2307.09288
- Eisenstein et al., Helping or Herding? Reward Model Ensembles Mitigate but do not Eliminate Reward Hacking, 2023. https://arxiv.org/abs/2312.09244
- Kimi Team, Kimi k1.5, 2025. https://arxiv.org/abs/2501.12599
- Gao et al., REBEL, 2024. https://arxiv.org/abs/2404.16767
- Weaver & Tao, The Optimal Reward Baseline for Gradient-Based Reinforcement Learning, UAI 2001. https://arxiv.org/abs/1301.2315
- Greensmith, Bartlett & Baxter, Variance Reduction Techniques for Gradient Estimates in Reinforcement Learning, JMLR 2004. https://jmlr.org/papers/v5/greensmith04a.html
- Shao et al., DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (GRPO), 2024. https://arxiv.org/abs/2402.03300
- Rafailov et al., Direct Preference Optimization: Your Language Model is Secretly a Reward Model (DPO), 2023. https://arxiv.org/abs/2305.18290